
La última generación de modelos de lenguaje, como GPT-4 y Gemini 1.5 Pro, ha sido promocionada como «multimodal», es decir, capaces de entender imágenes y audio además de texto. Sin embargo, un nuevo estudio revela que estos modelos no «ven» de la manera que podríamos esperar. De hecho, podrían no ver en absoluto.
La Ilusión de la Visión Artificial
¿Qué Significa Realmente «Ver»?
Para empezar, es importante aclarar que nadie ha afirmado que estas IA puedan ver como los humanos. Sin embargo, el marketing y los puntos de referencia utilizados para promocionar estos modelos hablan de «capacidades de visión» y «comprensión visual». Se nos dice que estos modelos pueden analizar imágenes y videos para realizar tareas que van desde resolver problemas escolares hasta ver eventos deportivos.
Aunque estas afirmaciones están formuladas de manera ingeniosa, queda claro que quieren transmitir que el modelo ve en algún sentido de la palabra. Pero ¿realmente lo hacen?
Un Estudio Revelador
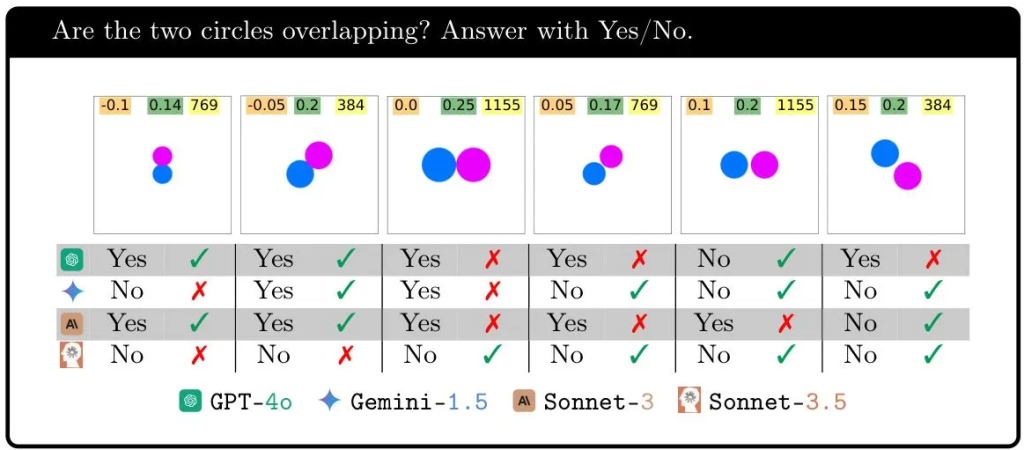
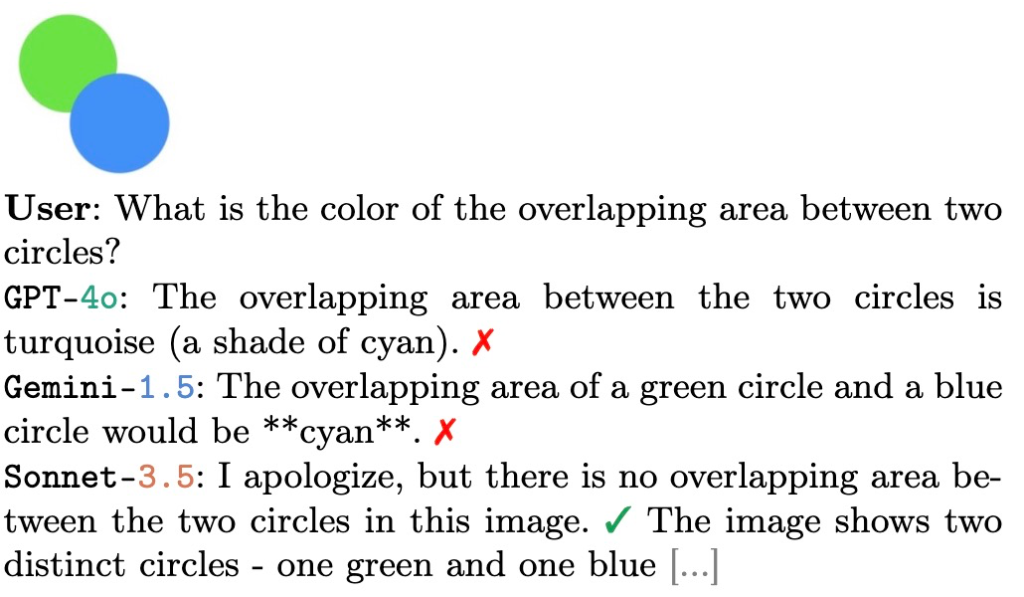
Un estudio realizado por investigadores de la Universidad de Auburn y la Universidad de Alberta probó los modelos multimodales más avanzados en tareas visuales muy simples. Estas pruebas incluían tareas como preguntar si dos formas se superponen, contar el número de pentágonos en una imagen, o identificar qué letra de una palabra está rodeada por un círculo. Tareas que un niño de primer grado podría realizar con un 100% de precisión.
Sin embargo, estos modelos de IA no lograron los mismos resultados. Por ejemplo, cuando se les presentaban dos círculos que se superponían ligeramente, que se tocaban o que estaban a cierta distancia entre ellos, los modelos fallaban en reconocer correctamente la situación. Aunque GPT-4 tuvo un 95% de éxito cuando los círculos estaban muy separados, su precisión bajaba al 18% cuando las distancias eran cero o pequeñas. Gemini Pro 1.5 fue el mejor, pero aún así solo acertó el 70% de las veces en distancias cercanas.
¿Qué Está Fallando?
Análisis de Datos de Entrenamiento
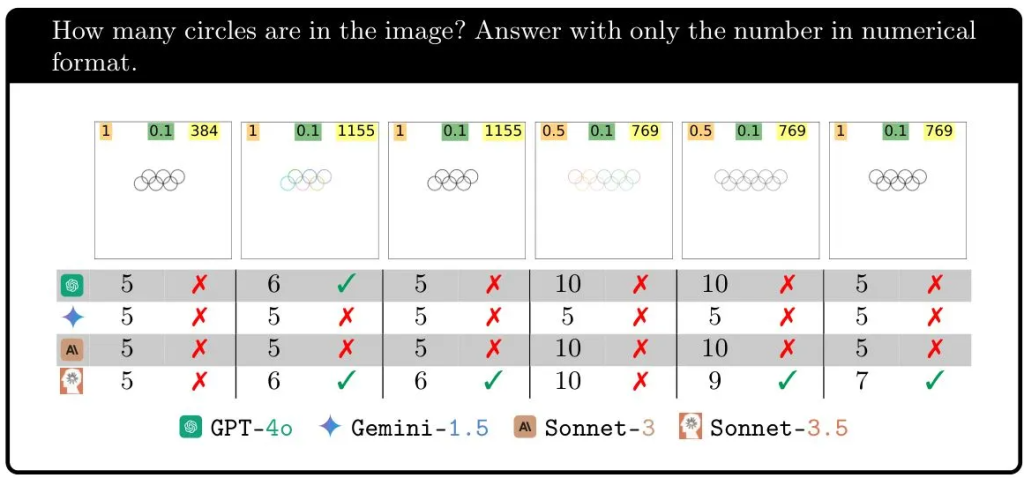
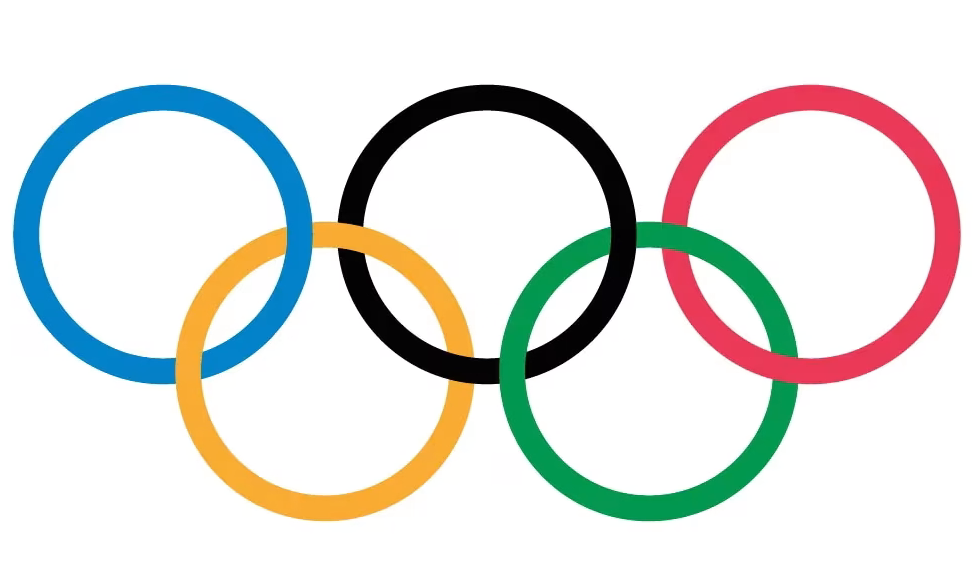
La inconsistencia en los resultados sugiere que los modelos no están «viendo» de la manera que esperamos. Por ejemplo, cuando se les pedía contar la cantidad de círculos entrelazados en una imagen, los modelos mostraban un rendimiento errático. Aunque todos acertaban el 100% de las veces con cinco anillos, agregar un anillo más devastaba sus resultados. ¿La razón? Probablemente, porque los Anillos Olímpicos, que son cinco, están ampliamente representados en sus datos de entrenamiento, pero seis anillos entrelazados no lo están.
¿Son Ciegos los Modelos de IA?
Los investigadores concluyen que estos modelos no tienen una comprensión visual real de los conceptos. Aunque «ciego» no es el término más preciso, es útil para describir la incapacidad de estos modelos para hacer juicios visuales. La información visual que extraen es abstracta y aproximada, similar a describir una imagen con los ojos cerrados.
Implicaciones y Siguientes Pasos
¿Son Inútiles Estos Modelos?
Definitivamente no. Aunque fallan en tareas de razonamiento visual simple, estos modelos son muy precisos en aspectos como interpretar acciones humanas y reconocer objetos cotidianos. Sus capacidades específicas siguen siendo valiosas, pero es crucial entender sus limitaciones.
La Necesidad de Investigaciones Críticas
El marketing puede llevarnos a pensar que estos modelos tienen una visión perfecta, pero investigaciones como esta demuestran que hay mucho por mejorar. Necesitamos seguir evaluando críticamente estas tecnologías para comprender mejor sus capacidades y limitaciones.
Conclusión
En resumen, aunque los modelos de IA actuales pueden manejar ciertas tareas visuales, su comprensión es limitada y errática. No ven como los humanos y sus capacidades visuales deben ser tomadas con cautela. La investigación continua es esencial para mejorar estas tecnologías y entender mejor cómo pueden ser utilizadas de manera efectiva.
Preguntas Frecuentes
1. ¿Pueden los modelos de IA realmente ver como los humanos?
No, los modelos de IA no ven como los humanos. Interpretan patrones en los datos de entrada basándose en su entrenamiento, pero no tienen una comprensión visual real.
2. ¿Son útiles estos modelos a pesar de sus limitaciones visuales?
Sí, estos modelos son muy precisos en tareas específicas como reconocer objetos y acciones humanas, aunque fallan en tareas de razonamiento visual simple.
3. ¿Qué debemos esperar de la evolución de estos modelos?
Podemos esperar mejoras en su precisión y capacidad para interpretar información visual, pero es importante seguir evaluándolos críticamente para entender sus verdaderas capacidades y limitaciones.